
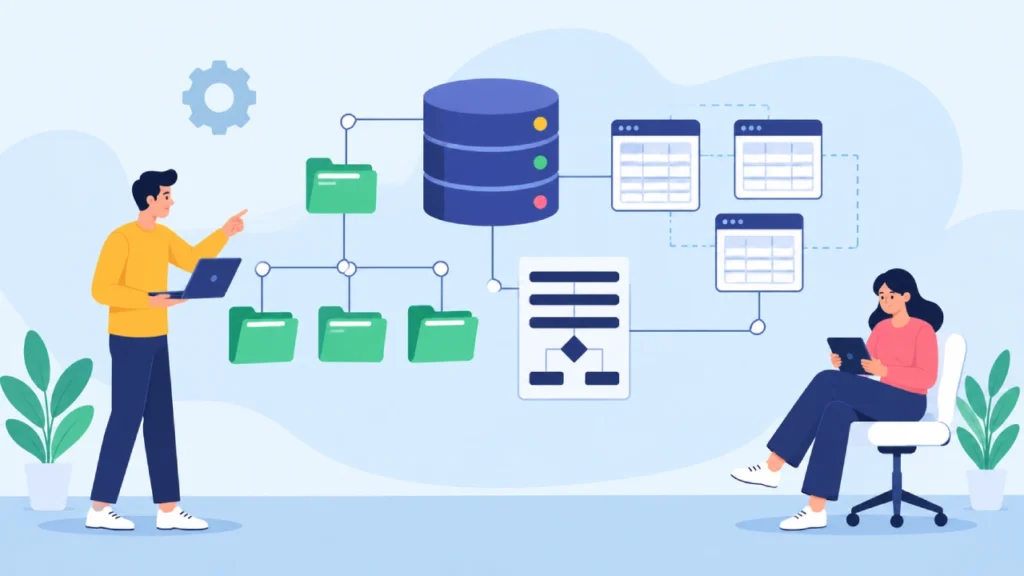

एक सु-निर्मित स्कीमा स्थिर बॅकएंडसाठी मध्यवर्ती आहे. ॲप जसजसे वाढत जाईल, डेटाबेसने अधिक डेटा, अधिक खाती, अधिक वाचन आणि लेखन आणि अधिक लिंक केलेले रेकॉर्ड हाताळले पाहिजेत. स्कीमा घाई केली असल्यास, हे बदल गोंधळात टाकू शकतात. संघ पुनरावृत्ती नोंदी, रांगेत नसलेल्या पंक्ती, धीमे क्वेरी आणि त्याचे निराकरण करण्यासाठी अतिरिक्त तर्क जोडू शकतात.
डेटाबेस स्कीमा हे डेटाबेसमध्ये डेटा कसा ठेवावा हे ठरवण्याबद्दल आहे. बॅकएंड संघांसाठी, याचा अर्थ टेबल आणि स्तंभ निवडणे, त्यांच्यामधील दुवे सेट करणे आणि की आणि नियम निवडणे. याचा अर्थ सिस्टम मोठा झाल्यावर डेटाबेस कसा वागतो हे पाहणे. उद्देश केवळ डेटा ठेवणे नाही. हे सेट अप करायचे आहे जेणेकरून वापर वाढला की बॅकएंड व्यवस्थापित करता येईल.
टेबल्स आणि ते काय करतात
रिलेशनल डेटाबेसमध्ये, टेबल्स पंक्ती आणि स्तंभांमध्ये डेटा ठेवतात. टेबल सहसा एक मुख्य गोष्ट किंवा एक स्पष्ट प्रकारची माहिती दर्शवते. उदाहरणार्थ, ऑनलाइन दुकान अनेकदा ग्राहक, वस्तू, खरेदी आणि बिलिंग तपशीलांसाठी स्वतंत्र टेबल ठेवते. जेव्हा तुम्ही स्कीमा डिझाइन करता, तेव्हा तुम्ही ॲपमधील प्रमुख घटक शोधून सुरुवात करता. ग्राहक टेबल उत्पादनाच्या तपशीलांमध्ये मिसळू नये.
ते आयटम एकाच प्रकारचे डेटा नाहीत आणि ते भिन्न भूमिका देतात. प्रत्येक घटकाला स्वतःच्या टेबलमध्ये ठेवल्याने लोकांना डेटा मॉडेल वाचण्यात मदत होते. हे भविष्यातील अद्यतनांना कमी वेदनादायक देखील करते. हे पुनरावृत्ती झालेल्या मूल्यांमध्ये देखील कपात करू शकते. प्रत्येक खरेदीसाठी तीच ग्राहक माहिती पुन्हा जतन करण्याऐवजी, सिस्टम ग्राहकाला एकदाच संग्रहित करते. मग ते त्या ग्राहकाच्या रेकॉर्डला प्रत्येक खरेदीशी जोडते.
स्तंभ आणि प्रकार निवडणे
एकदा टेबल सेट केल्यावर, बॅकएंड टीम प्रत्येक टेबलला कोणत्या कॉलमची गरज आहे ते निवडते. प्रत्येक स्तंभात एक कार्य असावे. त्याने डेटा प्रकार देखील वापरला पाहिजे जो तो संचयित करेल त्याच्याशी जुळतो.
उदाहरणार्थ, ग्राहकांच्या टेबलमध्ये आयडी, नाव, ईमेल आणि खाते तयार केल्याची तारीख समाविष्ट असू शकते. योग्य प्रकार निवडणे चुकीचे इनपुट अवरोधित करण्यात मदत करते. हे स्टोरेज आणि क्वेरी किती चांगले कार्य करतात ते देखील बदलू शकते. नेहमी काय भरले पाहिजे आणि काय रिक्त असू शकते हे देखील तुम्ही ठरवा. ईमेल पत्त्याला सहसा मूल्य आवश्यक असते, तर लहान बायो पर्यायी असू शकते. हे कॉल डिझाईन वेळेत केल्याने नंतर गोंधळ टळतो.
प्राथमिक की आणि अनन्य पंक्ती
बऱ्याच सारण्यांसाठी, तुम्हाला पंक्ती वेगळे सांगण्यासाठी एक विश्वासार्ह मार्ग आवश्यक आहे. ते काम प्राथमिक की द्वारे केले जाते. प्राथमिक की एका टेबलमधील विशिष्ट पंक्तीकडे निर्देश करते. काहीवेळा ते फक्त एक फील्ड असते, जसे user_id. इतर वेळी तुम्ही एकापेक्षा जास्त फील्ड वापरता. ही एक संमिश्र की आहे आणि ती एका स्तंभापेक्षा चांगली बसू शकते. डेटाबेस इंजिन प्राथमिक कीला विशिष्टतेसाठी नियम मानतात.
ते पंक्ती जलद शोधण्यासाठी देखील वापरतात. केवळ नावे नेहमीच पुरेशी नसतात. दोन लोक समान नाव सामायिक करू शकतात, परंतु त्यांचे वापरकर्ता आयडी अजूनही भिन्न राहतात. नंतर नंतर बदलू शकणाऱ्या डेटावर विसंबून राहण्याऐवजी एखादे ॲप वापरकर्त्यासाठी सुरक्षित संदर्भ संचयित करू शकते.
टेबल लिंक्स आणि नातेसंबंध
वास्तविक प्रणाली प्रत्येक गोष्ट स्वतंत्र बॉक्समध्ये ठेवत नाहीत. टेबल सहसा एकमेकांशी संबंधित असणे आवश्यक आहे. वन-टू-वन हे दुर्मिळ प्रकरण आहे जेथे एक पंक्ती दुसऱ्या सारणीतील एका पंक्तीशी मॅप करते. बऱ्याचदा आपण एक ते अनेक पहा. एकच ग्राहक अनेक ऑर्डर देऊ शकतो. प्रत्येक ऑर्डर, तरीही, फक्त एका ग्राहकाची आहे. मग अनेक नाती असतात. येथे, एक बाजू दुसऱ्या बाजूला अनेकांशी जोडू शकते.
ऑर्डरमध्ये अनेक उत्पादनांचा समावेश असू शकतो. एखादे उत्पादन अनेक ऑर्डरमध्ये दिसू शकते. हे हाताळण्यासाठी, तुम्ही ऑर्डर_आयटम्स सारखे जंक्शन टेबल तयार करा. ते टेबल जोड्या ठेवते आणि दोन्ही बाजूंना एकत्र बांधते. PostgreSQL हा नमुना त्याच्या डॉक्समध्ये देखील दाखवतो. हे स्पष्ट करते की अनेक-ते-अनेक लिंक्स मॉडेल करण्यासाठी एकाधिक परदेशी की वापरल्या जाऊ शकतात.
परदेशी की आणि संदर्भित अखंडता
परदेशी की महत्त्वाच्या आहेत कारण ते टेबल्स दरम्यान वास्तविक कनेक्शन तयार करतात. परदेशी की सेट केली जाऊ शकते म्हणून तिचे मूल्य संबंधित सारणीमध्ये असणे आवश्यक आहे. NOT NULL मर्यादासह, डेटाबेस गहाळ आवश्यक डेटा स्वीकारणार नाही. चेक कंस्ट्रेंट दिलेल्या स्थितीत बसणाऱ्या मूल्यांना मर्यादा घालते.
स्कीमा वाचणे सोपे ठेवणे
वेग महत्त्वाचा आहे, परंतु ते एकमेव ध्येय नाही. अधिक लोक संघात सामील होत असल्याने आणि ॲप मोठा होत असल्याने स्कीमा देखील स्पष्ट असणे आवश्यक आहे.
नामकरण सुसंगत राहिल्यास वेळेची बचत होते. टेबल लिंक्स स्पष्ट असल्यास आणि नियम स्पष्टपणे लागू केले असल्यास, विकासकांना अंदाज लावण्याची गरज नाही. PostgreSQL मध्ये, स्कीमा नेमस्पेसेसप्रमाणे काम करू शकतात. याचा अर्थ तुम्ही डेटाबेस आयटम्स गटबद्ध करू शकता आणि त्यांना वेगळे ठेवू शकता. तसेच, कागदपत्रे वगळू नका. संघांनी अस्तित्व संबंध आकृत्या किंवा तत्सम नोट्स सेव्ह केल्या पाहिजेत, जेणेकरून प्रत्येकजण मुख्य सारणी पाहू शकेल आणि ते कसे कनेक्ट होतात.
अंतिम विचार
डेटाबेस स्कीमा डिझाइन ही एक-वेळची पायरी नाही. वर्षानुवर्षे अभियांत्रिकीवर परिणाम करणारा हा निर्णय आहे. डेटा कुठे राहतो ते स्कीमा मांडते. हे तुकडे एकत्र कसे बसतात याचे नियम देखील सेट करते. मर्यादा वेळोवेळी डेटा योग्य ठेवण्यास मदत करतात. अनेक ठिकाणी समान मूल्ये कॉपी करणे टाळा. जेव्हा ते खरोखर खराब डेटा प्रतिबंधित करतात तेव्हा मर्यादा जोडा. टेबल्स आणि लिंक्सवर थांबू नका. निर्देशांकांची योजना लवकर करा. प्रश्न खऱ्या वापरात कसे चालतील ते पहा. डेटा कसा वाढू शकतो याचा विचार करा. सर्व काही न मोडता तुम्ही नंतर स्कीमा कसा बदलाल याची योजना करा.
(स्त्रोत)

Comments are closed.