
तंत्रज्ञानाची इकोसिस्टम कृत्रिम बुद्धिमत्तेद्वारे अधिकाधिक विश्लेषण-चालित आणि स्वयंचलित होत असल्याने, डेटा कोणत्याही संस्थेसाठी एक महत्त्वाचा घटक बनला आहे. तथापि, डेटाची उपलब्धता नेहमी डेटाच्या विश्वासार्हतेशी समतुल्य नसते. डॅशबोर्ड यशस्वीरित्या लोड होऊ शकतो, परंतु दर्शविलेले नंबर जुने असू शकतात. पाइपलाइन यशस्वीरीत्या चालू शकते, परंतु अपूर्ण डेटा जनरेट केला जाऊ शकतो. किंवा अपस्ट्रीम स्कीमामधील बदल देखील शांततेत डाउनस्ट्रीम ऍप्लिकेशन्सवर प्रभाव टाकू शकतात.
जेव्हा डेटा निरीक्षणक्षमतेची संकल्पना प्रत्यक्षात येते. डेटा निरीक्षणक्षमतेमध्ये तुमच्या डेटाची स्थिती, त्याचे आरोग्य, उपलब्धता आणि विश्वासार्हता जाणून घेणे समाविष्ट असते. डेटा निरीक्षणक्षमता विशिष्ट पाइपलाइन चालते की नाही याबद्दल नाही; तयार केलेला डेटा ताजा आहे आणि अपेक्षेप्रमाणे वागत आहे हे तुम्हाला कसे कळते.
डेटा निरीक्षणक्षमता म्हणजे काय?
डेटा निरीक्षणक्षमता विविध डेटा प्रक्रिया, प्रणाली आणि पाइपलाइनमध्ये डेटाची स्थिती समजून घेण्यासाठी निरीक्षण आणि देखरेख करण्याच्या प्रक्रियेचा संदर्भ देते. हे पारंपारिक मॉनिटरिंगचा विस्तार आहे ज्यामध्ये ते डेटा समस्यांशी संबंधित अधिक संदर्भ देते ज्याचा शोध घेणे आणि तपास करणे आवश्यक आहे.
पारंपारिक देखरेख इंजिनीअरिंग टीमला सूचित करेल की पाइपलाइनमध्ये समस्या आहे, निरीक्षणक्षमता काय घडले, समस्या कोठून सुरू झाली आणि कोणत्या डाउनस्ट्रीम डेटासेटवर परिणाम होऊ शकतो याबद्दल अतिरिक्त तपशील प्रदान करेल.
याचे महत्त्वाचे कारण म्हणजे प्रणाली तांत्रिकदृष्ट्या कार्य करत असू शकते, परंतु त्यातील डेटा असू शकत नाही. OpenTelemetry नुसार, ज्यांची निरीक्षणक्षमतेची व्याख्या फक्त सॉफ्टवेअर प्रणालींपेक्षा विस्तृत आहे, निरीक्षणक्षमता हे एक आवश्यक साधन आहे ज्याचा उपयोग संघांनी त्यांच्या प्रणालींना उत्सर्जित केल्या जाणाऱ्या माहितीच्या आधारे समजून घेण्यासाठी आणि ज्या मुद्द्यांचा आधीपासून अंदाज लावला नव्हता त्या तपासण्यासाठी केला जातो.
डेटा टीमच्या दृष्टीकोनातून, काही प्रश्नांचा समावेश असू शकतो: डेटा अद्ययावत आहे का? व्हॉल्यूम वेगळा आहे का? रचना वेगळी आहे का? डेटा आवश्यक गुणवत्ता मानके पूर्ण करतो का? मुद्दा कुठून सुरू झाला?
डेटा निरीक्षणक्षमतेचे मुख्य परिमाण
डेटा निरीक्षणक्षमता समजून घेण्याचा एक उपयुक्त मार्ग म्हणजे डेटा आरोग्याच्या अनेक मोजण्यायोग्य वैशिष्ट्यांद्वारे.
डेटा फ्रेशनेस: डेटा चालू आहे का?
अलीकडे डेटा किती अपडेट केला गेला आणि किती वारंवार अपडेट होतात याचे फ्रेशनेस वर्णन करते. ताजेपणाची योग्य पातळी वापराच्या केसवर अवलंबून असते. आर्थिक अनुप्रयोगासाठी काही सेकंदात किंवा मिनिटांत माहिती आवश्यक असू शकते, तर कमी वेळ-संवेदनशील व्यवसाय अहवालासाठी केवळ नियतकालिक अद्यतनांची आवश्यकता असू शकते.
डेटा निर्मिती, अंतर्ग्रहण आणि प्रक्रिया यांच्याशी संबंधित टाइमस्टॅम्पची तुलना करून ताजेपणा मोजला जाऊ शकतो. वाढता विलंब हे सूचित करू शकते की पाइपलाइन मागे पडत आहे.
Google क्लाउडचे डेटाफ्लो दस्तऐवजीकरण, उदाहरणार्थ, इव्हेंट वेळेशी प्रक्रिया वेळेची तुलना करून स्ट्रीमिंग पाइपलाइनमध्ये डेटा ताजेपणा परिभाषित करते. उच्च मूल्ये इव्हेंट केव्हा घडली आणि त्यावर प्रक्रिया केव्हा झाली या दरम्यान जास्त विलंब दर्शवतात. त्यामुळे नियोजित कार्य पूर्ण झाले की नाही हे जाणून घेण्यापेक्षा ताजेपणाचे निरीक्षण करणे अधिक माहिती प्रदान करते.
डेटा गुणवत्ता: डेटा अपेक्षेप्रमाणे वागत आहे का?
डेटा गुणवत्ता डेटा त्याच्या इच्छित वापरासाठी योग्य आहे की नाही याचा संदर्भ देते. अचूकता, पूर्णता, सातत्य, वैधता आणि समयसूचकता ही येथील प्रमुख वैशिष्ट्ये आहेत. डेटा निरीक्षण क्षमता संभाव्य डेटा गुणवत्तेची समस्या सूचित करणारे बदल शोधण्यासाठी वापरली जाऊ शकते, परंतु ते अचूकतेची हमी देत नाही.
संघ अशा निर्देशकांचे निरीक्षण करू शकतात जसे की:
- शून्य मूल्यांमध्ये अनपेक्षित वाढ
- डुप्लिकेट रेकॉर्ड
- असामान्य मूल्य वितरण
- गहाळ रेकॉर्ड
- डेटा श्रेणींमध्ये अनपेक्षित बदल
- अपूर्ण डेटासेट
उदाहरणार्थ, एक ग्राहक टेबल जे सहसा दिवसाला 100,000 रेकॉर्ड घेते परंतु अचानक फक्त 20,000 रेकॉर्ड असतात याचा अर्थ अपस्ट्रीममध्ये समस्या आहे. याव्यतिरिक्त, पूर्वी विश्वसनीय असलेल्या विशिष्ट डेटा फील्डमधील शून्य मूल्यांमध्ये आश्चर्यकारक वाढ म्हणजे अपस्ट्रीम सिस्टममध्ये काहीतरी बदलले आहे.
उद्देश फक्त अधिक मेट्रिक्स गोळा करणे नाही. सामान्य डेटा वर्तन कसे दिसते हे स्थापित करणे आणि अर्थपूर्ण विचलन ओळखणे हे आहे.
पाइपलाइन आरोग्य: डेटा यशस्वीरित्या हलविला गेला?
डेटा पाइपलाइन स्त्रोत, परिवर्तन, डेटाबेस, गोदाम आणि अनुप्रयोग कनेक्ट करतात. कोणत्याही क्षणी अपयश डाउनस्ट्रीम ग्राहकांना प्रभावित करू शकते.
पाइपलाइन निरीक्षणामध्ये नोकरीची स्थिती, प्रक्रियेचा कालावधी, पुन्हा प्रयत्न, त्रुटी, संसाधनांचा वापर आणि आउटपुट व्हॉल्यूम यांचा समावेश असू शकतो. Google क्लाउड दस्तऐवजीकरण हे दाखवते की पाइपलाइनचे टप्पे, लॉग, सिस्टम लेटन्सी आणि फ्रेशनेस यांचे निरीक्षण करणे टीमला संथ किंवा थांबलेल्या प्रक्रियेची तपासणी कशी मदत करू शकते.
हा फरक महत्त्वाचा आहे कारण एक पाइपलाइन वाढत्या मागे पडताना तांत्रिकदृष्ट्या सक्रिय राहू शकते. स्ट्रीमिंग वातावरणात, उदाहरणार्थ, वाढत्या स्रोत अनुशेष किंवा पुनरावृत्ती प्रक्रिया अपयश डेटा ताजेपणा विलंब वाढवू शकतात.
स्कीमा आणि व्हॉल्यूम बदल
जेव्हा त्याची रचना किंवा अपेक्षित व्हॉल्यूम बदलतो तेव्हा डेटा देखील अविश्वसनीय होऊ शकतो.
स्कीमा बदलामध्ये फील्डचा प्रकार जोडणे, काढून टाकणे किंवा बदलणे समाविष्ट असू शकते. जर डाउनस्ट्रीम सिस्टीम पूर्वीच्या संरचनेवर अवलंबून असेल तर, वरवर पाहता सोर्स-सिस्टम बदल इतरत्र बिघाड होऊ शकतात.
व्हॉल्यूम मॉनिटरिंग डेटा व्युत्पन्न किंवा प्रक्रिया केलेल्या प्रमाणात अनपेक्षित बदल शोधते. अचानक कमी होणे गहाळ डेटा दर्शवू शकते, तर असामान्य वाढ डुप्लिकेशन किंवा अपस्ट्रीम बदल सूचित करू शकते.
IBM ताजेपणा, वितरण, व्हॉल्यूम, स्कीमा आणि वंश हे डेटा निरीक्षणक्षमता समजून घेण्यासाठी प्रमुख स्तंभ म्हणून ओळखते
डेटा वंश: समस्या कोठे सुरू झाली हे समजून घेणे
शोध हा डेटा समस्येचे निराकरण करण्याचा फक्त एक भाग आहे. संघांना त्याचे मूळ आणि प्रभाव देखील समजून घेणे आवश्यक आहे.
येथे डेटा वंश मौल्यवान बनते. वंशावळी डेटाच्या स्त्रोतापासून डाउनस्ट्रीम डेटासेट आणि ऍप्लिकेशन्समध्ये प्रक्रियेच्या टप्प्यांद्वारे डेटाच्या हालचाली आणि परिवर्तनाचे वर्णन करते.
एक सरलीकृत प्रवाह विचारात घ्या:
स्रोत प्रणाली → अंतर्ग्रहण पाइपलाइन → परिवर्तन → डेटा कोठार → डॅशबोर्ड
डॅशबोर्डमध्ये अचानक चुकीची माहिती असल्यास, वंशावळ अभियंत्यांना त्या साखळीद्वारे संबंधित डेटा मागून काढण्यात मदत करू शकते.
OpenLineage, वंशाच्या मेटाडेटा संकलनासाठी खुले मानक, नोकरी आणि ते वापरत असलेल्या आणि तयार केलेल्या डेटासेटमधील संबंधांचे मॉडेल. त्याचे मॉडेल जटिल पाइपलाइनमधून जात असताना डेटासेटच्या निरीक्षणास समर्थन देण्यासाठी डिझाइन केलेले आहे.
हा संदर्भ एखाद्या घटनेदरम्यान आवश्यक असलेल्या मॅन्युअल तपासणीचे प्रमाण कमी करू शकतो. प्रत्येक घटकाचे स्वतंत्रपणे परीक्षण करण्याऐवजी, संघ अवलंबित्व ओळखण्यासाठी वंशाचा वापर करू शकतात आणि पाइपलाइनच्या संबंधित भागावर त्यांचे अन्वेषण केंद्रित करू शकतात.
डेटा निरीक्षणक्षमता उत्तम तंत्रज्ञान निर्णयांना कसे समर्थन देते
निरीक्षणाचे मूल्य वैयक्तिक घटना निश्चित करण्यापलीकडे विस्तारते. डेटा विश्वासार्हतेबद्दल ऐतिहासिक माहिती तंत्रज्ञानाच्या विस्तृत निर्णयांची माहिती देऊ शकते.
उदाहरणार्थ, एखाद्या विशिष्ट पाइपलाइनला उच्च विलंब, वारंवार बिघाड किंवा वारंवार ताजेपणाचे उल्लंघन होत असल्याचे निरीक्षण सातत्याने दाखवत असल्यास, अभियंत्यांना पुरावे आहेत की अंतर्निहित आर्किटेक्चरचे पुनरावलोकन करणे आवश्यक असू शकते.
त्याचप्रमाणे निरीक्षणक्षमता संस्थांना अभियांत्रिकी प्रयत्न कुठे केंद्रित करावे हे ओळखण्यात मदत करू शकतात. क्वचितच वापरल्या जाणाऱ्या डेटासेटला प्रभावित करणाऱ्या समस्येचा डझनभर व्यवसाय-गंभीर अहवाल आणि अनुप्रयोगांना प्रभावित करणाऱ्या अपयशापेक्षा वेगळा ऑपरेशनल प्रभाव असू शकतो.
ही माहिती वेळोवेळी तंत्रज्ञान निवडींचे मूल्यांकन करण्यात संघांना मदत करू शकते. पाइपलाइन अयशस्वी होण्याचे दर, प्रक्रियेचा कालावधी, ताजेपणाचे कार्यप्रदर्शन आणि आवर्ती गुणवत्तेच्या घटनांसारखे मेट्रिक्स हे उघड करू शकतात की प्लॅटफॉर्म किंवा आर्किटेक्चर ऑपरेशनल समस्या कोठे निर्माण करत आहे.
याचा परिणाम म्हणजे तंत्रज्ञानाच्या निर्णयांपासून मुख्यत: गृहितकांवर आधारित ऑपरेशनल पुराव्यांद्वारे समर्थित निर्णयांकडे बदल.
प्रतिक्रियात्मक समस्यानिवारणापासून ते सक्रिय डेटा व्यवस्थापनापर्यंत
निरीक्षणक्षमता उपस्थित नसल्यास, डेटाच्या ग्राहकांद्वारे त्रुटी लक्षात येतील. एका प्रकरणात, विश्लेषक डॅशबोर्डची काही असामान्यता लक्षात घेईल; दुसऱ्यामध्ये, व्यवसाय वापरकर्ता माहितीच्या अभावाची तक्रार करेल; आणि दुसऱ्या बाबतीत, अनुप्रयोग अनपेक्षित परिणाम निर्माण करेल.
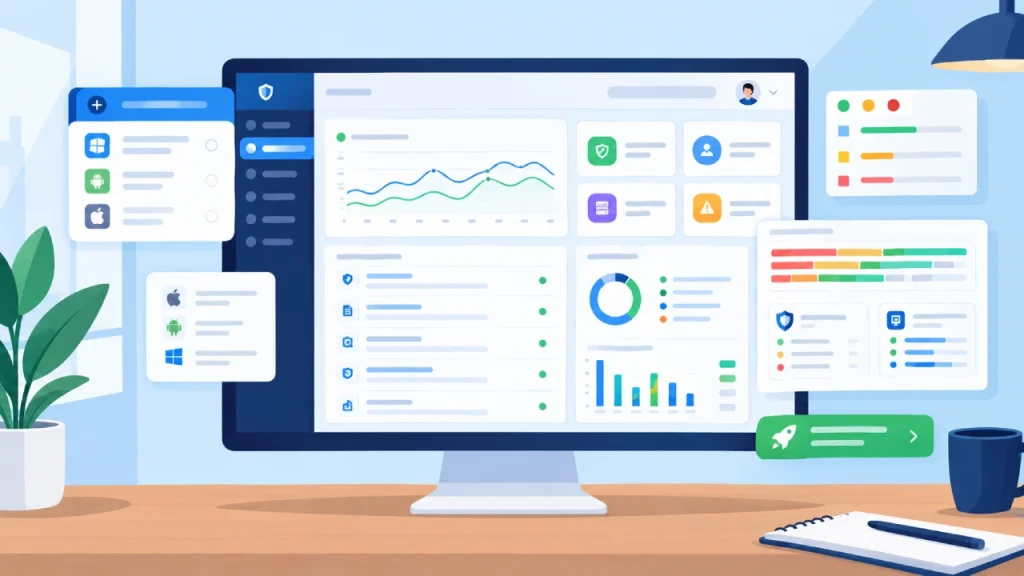
त्रुटी लक्षात येईपर्यंत, ती बहुधा अनेक अनुप्रयोगांमध्ये पसरेल. निरीक्षणक्षमता समस्येबद्दल अधिक सक्रिय वृत्ती घेण्यास अनुमती देते. हे अपेक्षा सेट करण्यास, डेटा वर्तनाचे विश्लेषण करण्यास आणि काहीतरी महत्त्वपूर्ण बदलते तेव्हा अलार्म सेट करण्यास अनुमती देते. उदाहरणार्थ, IBM ताजेपणा धोरणे, अलार्म, पाइपलाइन कार्यप्रदर्शन इतिहास आणि अवलंबित्व यासारख्या डेटा निरीक्षणाच्या वैशिष्ट्यांबद्दल बोलतो.
गुगल क्लाउडने असेही नमूद केले आहे की पाइपलाइन विसंगती आणि विलंब शोधण्यासाठी ताजेपणाची लक्ष्ये आणि मॉनिटरिंग मेट्रिक्स वापरली जातात.
सर्व संभाव्य चुका होण्यापासून रोखणे हा येथे उद्देश नाही. त्यांचे स्वरूप, शोध आणि विश्लेषण यामधील वेळ कमी करणे हे उद्दिष्ट आहे.
एक प्रभावी डेटा निरीक्षण धोरण तयार करणे
संस्थांना प्रत्येक डेटासेटचे तंतोतंत तशाच प्रकारे निरीक्षण करणे आवश्यक नाही. व्यवसाय आणि ऑपरेशनल प्रक्रियेसाठी सर्वात महत्त्वाच्या असलेल्या डेटा मालमत्ता ओळखून एक व्यावहारिक धोरण सुरू होते.
टीम नंतर त्या मालमत्तेसाठी ताजेपणाची आवश्यकता, स्वीकार्य प्रक्रिया वेळा, अपेक्षित डेटा व्हॉल्यूम आणि गुणवत्ता थ्रेशोल्डसह मोजण्यायोग्य अपेक्षा स्थापित करू शकतात.
जेथे अवलंबित्व समजून घेणे महत्त्वाचे आहे तेथे वंशाचा समावेश केला पाहिजे. अलर्ट्स देखील काळजीपूर्वक डिझाइन केले पाहिजेत. अत्याधिक सूचना सतर्क थकवा निर्माण करू शकतात आणि वास्तविक घटना ओळखणे कठिण बनवू शकतात.
मुख्य गोष्ट अशी आहे की संस्थांना डेटा गुणवत्ता, प्रशासन आणि सुरक्षितता यापासून निरीक्षणक्षमता वेगळे करणे आवश्यक आहे. हे दर्शवेल की विशिष्ट डेटासेटमध्ये काहीतरी चूक झाली आहे, परंतु तरीही ते समस्येचे निराकरण करणार नाही. IBM हे तथ्य हायलाइट करते की निरीक्षणक्षमता उच्च-गुणवत्तेचा डेटा प्राप्त करण्यास मदत करते, परंतु ते चांगल्या-गुणवत्तेच्या डेटाची खात्री करत नाही.
डेटा विश्वासार्हतेचे भविष्य
संस्था रिअल-टाइम ॲनालिटिक्स, मशीन लर्निंग आणि ऑटोमेटेड सिस्टीमवर अधिक अवलंबून असल्याने, अविश्वसनीय डेटाचे परिणाम एका अहवाल किंवा डेटाबेसच्या पलीकडे वाढू शकतात.
डेटा निरीक्षणक्षमता हे समजून घेण्यासाठी एक फ्रेमवर्क प्रदान करते की माहिती अपेक्षित असताना पोहोचते, सामान्यपणे वागते आणि तंत्रज्ञान स्टॅकद्वारे यशस्वीरित्या पुढे जाते. ताजेपणाचे मोजमाप विलंब प्रकट करू शकते; गुणवत्ता निर्देशक अनपेक्षित बदल उघड करू शकतात; पाइपलाइन निरीक्षण अपयश ओळखू शकते; आणि वंश अवलंबित्व आणि प्रभावाविषयी संदर्भ देऊ शकतात.
शेवटी, प्रश्न यापुढे फक्त “डेटा पाइपलाइन चालू आहे का?” “आम्ही डेटाची स्थिती त्यावर अवलंबून राहण्याइतपत चांगल्या प्रकारे समजू शकतो का?”
तो फरक डेटा निरीक्षणक्षमता दुसर्या देखरेख सराव पेक्षा अधिक करते. डेटा गुणवत्ता, प्रशासन आणि ध्वनी अभियांत्रिकी प्रक्रियांसोबत अंमलात आणल्यास, ते दृश्यमानता प्रदान करू शकते ज्या संस्थांना वाढत्या जटिल डेटा वातावरणांचे व्यवस्थापन करणे आवश्यक आहे—आणि ते वातावरण प्रत्यक्षात कसे कार्य करते याच्या पुराव्यावर आधारित तंत्रज्ञान निर्णय घेऊ शकतात.

Comments are closed.