

सर्वम AI, Saaras V4 सह उच्चार ओळखण्यासाठी अधिक भारत-विशिष्ट दृष्टीकोन घेत आहे, त्याचे नवीनतम स्वयंचलित उच्चार ओळख मॉडेल 22 भारतीय भाषा आणि इंग्रजीमध्ये कार्य करण्यासाठी डिझाइन केलेले आहे. सर्वमने 24 ऑगस्ट रोजी सारस V4 ची घोषणा केली आणि त्याचे दस्तऐवजीकरण असे दर्शविते की मॉडेल साधारणपणे 2 सप्टेंबर रोजी उपलब्ध झाले.
हे ऑडिओ एन्कोडर आणि 3-अब्ज-पॅरामीटर हायब्रिड स्टेट-स्पेस लँग्वेज मॉडेलच्या संयोजनाभोवती तयार केले गेले आहे जे सर्वम म्हणतो की ते अगदी सुरुवातीपासूनच प्रशिक्षित आहे. कंपनीची खेळपट्टी अशी नाही की मॉडेल अधिक भाषा ओळखते.
त्याऐवजी, Saaras V4 ची रचना काही समस्यांभोवती केली गेली आहे ज्यामुळे भारतीय भाषण विशेषतः स्वयंचलित प्रणालींसाठी कठीण होते: कोड-स्विचिंग, बोलीतील भिन्नता, गोंगाट करणारा ऑडिओ आणि समान उच्चारित सामग्रीचे प्रतिनिधित्व करण्याचे अनेक मार्ग. सामान्य उपलब्धतेपासून, सर्वमने त्याच्या रीअलटाइम API मध्ये Saaras V4 जोडले आहे आणि त्याच्या स्पीच एंडपॉइंट्सवर कीटर्म प्रॉम्प्टिंग सपोर्टचा विस्तार केला आहे, ज्यामुळे विकसित होत असलेल्या उत्पादन APIचा मॉडेल भाग बनला आहे.
Saaras V4 22 भारतीय भाषा आणि पाच आउटपुट मोडला सपोर्ट करते
Saaras V4 चा सर्वात तात्काळ उपयुक्त भाग हा आहे की ते उच्चार ओळखण्याला फक्त त्याच भाषेतील ऑडिओ शब्दांमध्ये रूपांतरित करत नाही.
सर्वम विकसकांना पाच आउटपुट मोड देते: ट्रान्स्क्राइब, ट्रान्सलेट, व्हर्बॅटिम, ट्रान्सलिट आणि कोडमिक्स. हे मोड समान अंतर्निहित ऑडिओ इनपुटवर लागू केले जाऊ शकतात, जरी त्यांचे समर्थित आउटपुट वर्तन वेगळे आहे.
- नक्कल करा मूळ भाषेत मजकूर तयार करते आणि हा पारंपारिक स्पीच-टू-टेक्स्ट पर्याय आहे.
- भाषांतर करा समर्थित भारतीय भाषेतील भाषणाचे इंग्रजीमध्ये भाषांतर करते. जेव्हा मूळ संभाषण इंग्रजी-भाषिक वापरकर्त्यासाठी किंवा डाउनस्ट्रीम सिस्टमसाठी प्रवेशयोग्य बनवणे आवश्यक असते तेव्हा ते उपयुक्त असते, परंतु ते कोणत्याही दोन समर्थित भाषांमधील अप्रतिबंधित भाषांतर म्हणून समजले जाऊ नये.
- शब्दशः फिलर शब्द आणि पुनरावृत्ती यांसारख्या वैशिष्ट्यांसह, एखादी गोष्ट प्रत्यक्षात कशी बोलली गेली हे जतन करण्याचा हेतू आहे.
- ट्रान्सलिट मान्यताप्राप्त भाषण रोमन लिपीत रूपांतरित करते. जेव्हा वापरकर्ता भारतीय भाषा बोलतो परंतु लॅटिन वर्णमाला वापरून ती वाचण्यास प्राधान्य देतो तेव्हा हे उपयुक्त ठरू शकते.
- कोडमिक्स संभाषणांसाठी डिझाइन केलेले आहे ज्यात भाषा नैसर्गिकरित्या मिसळल्या जातात, जसे की हिंदी-इंग्रजी भाषण. प्रत्येक शब्द एकाच भाषेत सक्ती करण्याऐवजी, आउटपुट संभाषणातील मिश्र-भाषेतील वर्ण राखू शकतो.
सर्वम म्हणतात की या क्षमता एका मॉडेलमध्ये ठेवल्याने अतिरिक्त प्रक्रिया टप्पे देखील टाळले जातात ज्यामुळे कॅस्केडिंग त्रुटी येऊ शकतात.
आर्किटेक्चर वेगळे का आहे
एन्कोडर इनकमिंग स्पीच सिग्नलवर प्रक्रिया करतो, तर डीकोडर विनंती केलेले मजकूर प्रतिनिधित्व व्युत्पन्न करतो. सर्वम म्हणतात की डीकोडर हे कंपनीने सुरवातीपासून प्रशिक्षित केलेले 3-अब्ज पॅरामीटर हायब्रिड राज्य-स्पेस भाषेचे मॉडेल आहे. तो भेद महत्त्वाचा.
Saaras V4 च्या 3B मॉडेलचे वर्णन स्वतंत्र सामान्य-उद्देश LLM म्हणून केले जाऊ नये. हा स्पीच-ओळखण्याच्या सिस्टीममधील भाषा-मॉडेल घटक आहे, जेथे त्याच्या कार्यामध्ये ध्वनिक माहितीचा अर्थ लावणे आणि योग्य आउटपुट स्वरूप तयार करणे समाविष्ट आहे.
डिकोडरला सुरवातीपासून प्रशिक्षित करण्याचा सर्वमचा निर्णय देखील उच्चार ओळखण्याच्या विशिष्ट आवश्यकता प्रतिबिंबित करतो. बहुभाषिक भाषणाभोवती डिझाइन केलेल्या डीकोडरला भाषिक नमुन्यांचा सामना करावा लागतो जे सामान्य मजकूर मॉडेलद्वारे चांगले प्रतिनिधित्व केले जाऊ शकत नाहीत, विशेषत: जेव्हा लक्ष्यात कमी-संसाधन भाषा, कोड-मिश्रित भाषण आणि बोली-भाषेतील अनियमितता समाविष्ट असते. परिणाम म्हणजे भाषणाच्या कार्याभोवती डिझाइन केलेले आर्किटेक्चर.
गोंगाटयुक्त आणि कोड-मिश्रित भारतीय भाषणासाठी डिझाइन केलेले
वास्तविक जगातील भारतीय भाषण प्रयोगशाळेतील रेकॉर्डिंगइतके क्वचितच स्वच्छ असते. लोक गर्दीच्या वातावरणात बोलतात, एकाच वाक्यात भाषा बदलतात, प्रादेशिक उच्चार वापरतात आणि औपचारिक आणि संभाषणात्मक शब्दसंग्रहामध्ये जातात. बोली भिन्नता देखील एकच भाषा बेंचमार्क डेटासेट सुचवू शकते त्यापेक्षा कमी एकसमान बनवू शकते.
सर्वम सांगतात की त्यांनी या अटींविरुद्ध विशेषतः Saaras V4 चे प्रशिक्षण दिले आणि त्याचे मूल्यांकन केले. कंपनीने मॉडेलचे वर्णन केले आहे की ते गोंगाट आणि कोड-मिश्रित ऑडिओमध्ये मजबूती सुधारण्यासाठी डिझाइन केलेले आहे, तसेच बोली भिन्नता आणि भाषा ओळख देखील संबोधित करते. कॉल सेंटर्स, व्हॉईस एजंट्स आणि फील्ड रेकॉर्डिंग सारख्या अनुप्रयोगांसाठी हे महत्त्वाचे आहे, जेथे वापरकर्ते काळजीपूर्वक रेकॉर्ड केलेल्या, प्रमाणित वाक्यांमध्ये बोलण्याची शक्यता नाही.
सर्वम सर्व 22 भारतीय भाषांमधील 5.22% च्या तुलनेत 10 सर्वाधिक बोलल्या जाणाऱ्या भारतीय भाषांमध्ये 2.9% भाषा-ओळख त्रुटी दर नोंदवते, सत्यापित IndicVoices डेटा वापरून. हे सर्वम-रिपोर्ट केलेले भाषा-ओळखता त्रुटी दर आहेत, शब्द त्रुटी दर आकडे नाहीत, म्हणून त्यांचा प्रतिलेखन अचूकतेचे थेट मोजमाप म्हणून अर्थ लावला जाऊ नये.
सर्वमचे बेंचमार्क दावे मॉडेलची महत्त्वाकांक्षा दर्शवतात
सारस V4 ने सर्व 22 भारतीय भाषांमध्ये त्याच्या मूल्यमापनात अत्याधुनिक कामगिरी केल्याचा अहवाल सर्वम सांगतो.
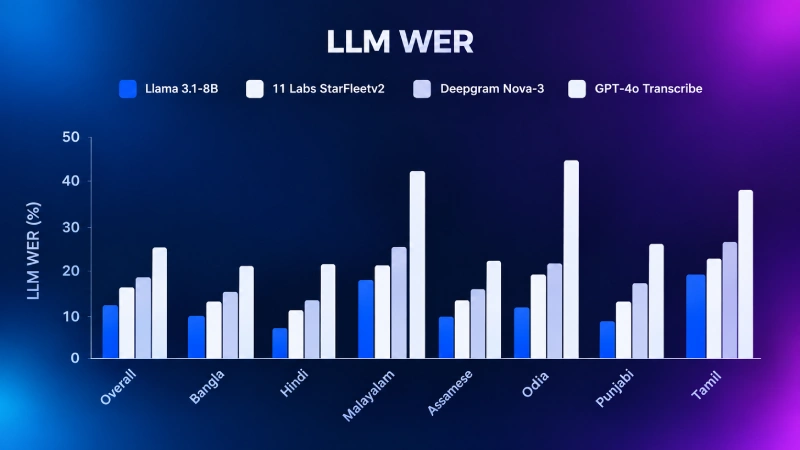
भारतीय-भाषेतील चाचणीसाठी, सर्वमने पारंपारिक शब्द त्रुटी दर आणि LLM-WER दोन्ही वापरून 10 भाषांमध्ये विस्तार बेंचमार्क वापरून मॉडेलचे मूल्यांकन केले. WER लिप्यंतरण त्रुटींचे मोजमाप करते, तर सर्वम LLM-WER चे वर्णन लिप्यंतरणातील फरक खरोखर सामग्रीचा अर्थ बदलतात की नाही हे लक्षात घेण्याच्या उद्देशाने अतिरिक्त अर्थविषयक मूल्यांकन म्हणून करतात. सर्वमने मीटिंग्ज, पॉडकास्ट, आर्थिक कॉल्स, सामान्य भाषण आणि विविध इंग्रजी उच्चारांसह सात इंग्रजी स्पीच-रिकग्निशन डेटासेटवर सारस V4 चे मूल्यमापन केले.
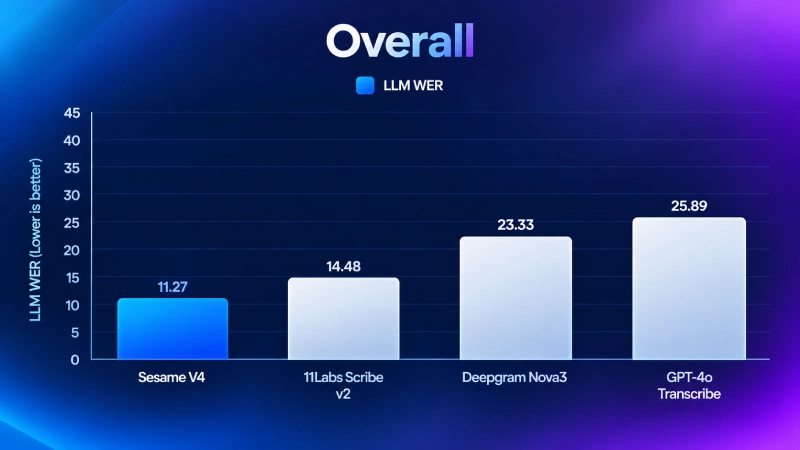
कंपनीने अहवाल दिला आहे की Saaras V4 ने त्या सात डेटासेटमध्ये सर्वात कमी सरासरी वर्ड एरर रेट नोंदवला आहे, त्यापैकी सहा परदेशी इंग्रजी बोलींचे प्रतिनिधित्व करतात आणि त्यापैकी एक भारतीय इंग्रजीचे प्रतिनिधित्व करते. हे सर्वमचे नोंदवलेले बेंचमार्क परिणाम आहेत. कोणत्याही दावा केलेल्या अत्याधुनिक किंवा सर्वात कमी-WER निकालाचा अर्थ लावताना डेटासेट, मूल्यमापन सेटअप आणि तुलना मॉडेल महत्त्वाचे असतात.
रिअल-टाइम स्पीच रेकग्निशन हा उत्पादनाचा भाग आहे
Saaras V4 देखील अशा अनुप्रयोगांसाठी आहे जेथे संपूर्ण रेकॉर्डिंग पूर्ण होण्याची प्रतीक्षा करणे व्यावहारिक नाही. सर्वम स्ट्रीमिंग ऍप्लिकेशन्ससाठी 150 मिलीसेकंदच्या खाली प्रथम टोकनसाठी वेळ नोंदवतो. मॉडेल त्याच्या वेबसॉकेट-आधारित रिअल-टाइम इन्फ्रास्ट्रक्चरद्वारे आंशिक परिणाम प्रदान करू शकते, ज्यामुळे ते व्हॉइस एजंट आणि थेट प्रतिलेखनासाठी योग्य बनते.
त्याची वर्तमान API उपलब्धता साध्या स्ट्रीमिंग एंडपॉइंटपेक्षा विस्तृत आहे. सर्वम REST, बॅच आणि वेबसॉकेट पर्याय प्रदान करतो. REST लहान रेकॉर्डिंगसाठी सिंक्रोनस ट्रान्सक्रिप्शनला समर्थन देते, तर बॅच API दोन तासांपर्यंत फायलींवर प्रक्रिया करू शकते आणि स्पीकर डायरायझेशनला समर्थन देते. वेबसॉकेट पर्याय थेट अनुप्रयोगांसाठी स्ट्रीमिंग ट्रान्सक्रिप्शन प्रदान करतात. Vercel AI SDK, LiveKit एजंट आणि Pipecat एजंट्ससह प्लॅटफॉर्म आणि फ्रेमवर्कसाठी एकत्रीकरणासह, विकासक Sarvam's Python आणि Node.js SDK द्वारे Saaras V4 मध्ये प्रवेश करू शकतात. सप्टेंबर अद्यतने देखील दर्शविते की मॉडेल उत्पादन API म्हणून विकसित केले जात आहे.
सर्वमने 3 सप्टेंबर रोजी रीअलटाइम API मध्ये Saaras V4 जोडले. त्यानंतर REST, बॅच आणि वेबसॉकेट वापरासाठी Keyterm प्रॉम्प्टिंग सुरू करण्यात आले आणि 22 सप्टेंबरच्या अपडेटने लेगसी WebSocket आणि Realtime WebSocket एंडपॉइंट्स या दोन्हीसाठी keyterm प्रॉम्प्टिंग विस्तारित केले. की टर्म्स डेव्हलपरना नावे, ठिकाणे, ब्रँड किंवा तांत्रिक संज्ञांबद्दल पूर्वाग्रह ओळखण्याची परवानगी देतात की त्या अटी आउटपुटमध्ये दिसतील याची हमी न देता.
तथापि, सारस V4 सर्वमच्या स्पीच API मध्ये स्वयंचलितपणे डीफॉल्ट मॉडेल नाही. सारस V3 हे सर्वमच्या वर्तमान दस्तऐवजात डीफॉल्ट किंवा शिफारस केलेले मॉडेल राहिले आहे, रीअलटाइम API साठी. विकसकांनी स्पष्टपणे Saaras V4 निवडणे आवश्यक आहे, जेथे समर्थित आहे, वापरून saaras:v4.
सारस V4 वि सारस V3
Saaras V4 V3 सारख्याच मूळ उद्देशावर बनते. दोन्ही आवृत्त्या पाच आउटपुट मोड आणि त्याच 22 भारतीय-भाषा कव्हरेजला समर्थन देतात. V4 साठी नोंदवलेला सर्वात लक्षणीय विस्तार इंग्रजी आहे: V3 हा भारतीय इंग्रजीवर लक्ष केंद्रित करतो, तर V4 जागतिक इंग्रजी उच्चारांना देखील मान्यता देतो.
एक महत्त्वपूर्ण उत्पादन-स्थिती तपशील देखील आहे. सारस V3 हे सर्वमच्या वर्तमान दस्तऐवजीकरणात डीफॉल्ट शिफारस केलेले मॉडेल आहे, तर V4 हे नवीन मॉडेल आहे आणि ते स्पष्टपणे निवडले जाऊ शकते. saaras:v4. रिअलटाइम API देखील V3 रिअलटाइमला डीफॉल्ट म्हणून सूचीबद्ध करते आणि V4 पर्याय म्हणून उपलब्ध करून देते. म्हणजे “नवीनतम मॉडेल“आणि”डीफॉल्ट मॉडेल” सध्या सर्वमच्या API स्टॅकमध्ये समानार्थी नाहीत.
भारतीय आवाज AI साठी सारस V4 चा अर्थ काय असू शकतो
सारस V4 चे व्यावहारिक महत्त्व शेवटी 22 क्रमांकाबद्दल कमी आणि एका प्रणालीमध्ये किती उच्चार समस्या सोडवण्याचा प्रयत्न करते याबद्दल अधिक आहे. एक बहुभाषिक कॉल-विश्लेषण प्लॅटफॉर्म बंगाली संभाषण लिप्यंतरण करू शकतो, कोड-मिश्रित इंग्रजी संज्ञा ओळखू शकतो आणि स्पीकर वेगळे ठेवू शकतो. व्हॉईस एजंट रिअल टाइममध्ये हिंदी-इंग्रजी भाषणावर प्रक्रिया करू शकतो. प्रादेशिक-भाषेतील ऍप्लिकेशन मूळ-लिपीचे लिप्यंतरण देऊ शकते आणि लॅटिन लिपी वाचण्यास अधिक सोयीस्कर असलेल्या वापरकर्त्यांसाठी रोमनीकृत आउटपुट प्रदान करते.
ते कार्यप्रवाह भारतात विशेषतः संबंधित आहेत कारण भाषेची निवड बऱ्याचदा प्रवाही असते. एक वक्ता भाषा बदलू शकतो, इंग्रजी शब्दावली भारतीय भाषेतील वाक्यात मिसळू शकतो, प्रादेशिक शब्दसंग्रह वापरू शकतो आणि कमी-गुणवत्तेच्या फोन कनेक्शनद्वारे बोलू शकतो, हे सर्व समान परस्परसंवादात. हीच समस्या Saaras V4 सोडवण्याचा प्रयत्न करत आहे.
सर्वमचे स्वतःचे बेंचमार्क दावे अजूनही त्यांच्या मूल्यमापन संदर्भात समजून घेणे आवश्यक आहे, परंतु आर्किटेक्चर आणि API डिझाइन एका व्यापक उद्दिष्टाकडे निर्देश करतात: वास्तविक बहुभाषिक संप्रेषणाच्या गोंधळलेल्या परिस्थितीत उच्चार ओळखणे उपयुक्त बनवणे. 22 भारतीय भाषा, जागतिक इंग्रजी समर्थन, पाच आउटपुट मोड, स्ट्रीमिंग ओळख आणि उत्पादन API सह, Saaras V4 हे दुसरे ट्रान्सक्रिप्शन मॉडेल म्हणून कमी आणि भारताच्या भाषिक विविधतेच्या आसपास आवाज अनुप्रयोग तयार करण्यासाठी पायाभूत सुविधा म्हणून अधिक स्थानावर आहे.
(स्त्रोत)

Comments are closed.